SemIf — семантические if'ы на открытых моделях
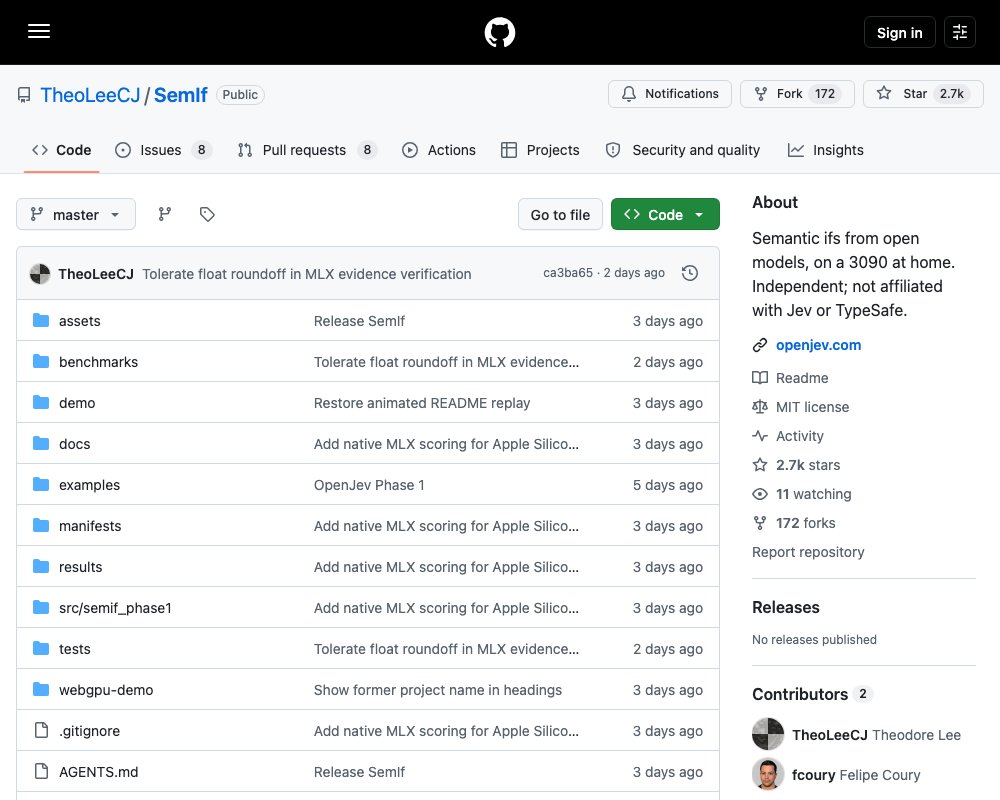
📂 Исходный код на GitHubСемантические if'ы на открытых моделях — альтернатива закрытому сервису Jev от TypeSafe для runtime-решений
Большинство решений в AI-агентах — мелкие: маршрутизация, повторные попытки, проверка фактов. Chat-модель справится, но тратит время на генерацию текста, который софт тут же парсит обратно в if.
SemIf (бывший OpenJev) — независимый open-source проект, воспроизводящий интерфейсный паттерн закрытого сервиса Jev от TypeSafe с помощью открытых моделей. Суть: одно forward-прохождение модели возвращает вероятности вариантов без генерации ответного текста, JSON-ремонта или циклов декодирования.
Проект работает на потребительском GPU (RTX 3090) и доступен прямо в браузере через WebGPU — без листа ожидания.
Зачем это нужно
Типичный AI-агент принимает десятки решений в минуту: какой инструмент вызвать, стоит ли повторять попытку, подтверждает ли evidence тезис. Каждое такое решение — это классический if, но вместо него агент генерирует текст, а парсер вытаскивает из него структуру. Это медленно и хрупко.
SemIf предлагает альтернативу: модель не генерирует ответ, а сразу выдаёт распределение вероятностей по вариантам. Нулевые токены, нулевой JSON-ремонт. Это жёсткая контрактная форма — на вход подаётся JSON с состоянием, вопросом и вариантами, на выходе — числа.
Как работает
На вход подаётся JSON с состоянием, критерием и вариантами:
{
  "id": "route-1",
  "state": "Customer cannot access an account after a password reset.",
  "question": "Which queue should handle this request?",
  "options": [
    {"id": "access", "description": "Account access support."},
    {"id": "billing", "description": "Billing support."}
  ]
}
Модель считывает логиты вариантов напрямую и возвращает вероятности. Ключевые свойства:
- Runtime-defined — критерии и описания вариантов приходят с запросом.
- Decision-native — одно forward-прохождение, без семплирования ответного токена.
- Shared-state — одно состояние можно предзагрузить один раз и ветвить по критериям.
- Auditable — фикстуры, раннеры, row-level результаты, ревизии и промпты закоммичены.
Скорость
Тесты на RTX 3090 с замороженной Qwen3.5-4B, одним состоянием и 21 бинарным критерием:
| Подход | Время | Токены | Результат |
|---|---|---|---|
| Direct typed logits | 1.023 с | 0 | 21 пара вероятностей |
| Autoregressive JSON array | 5.332 с | 111 | Валидный массив |
Прямое чтение логитов в 5.21× быстрее генерации массива.
При повторном использовании состояния на 777 решениях (37 состояний × 21 критерий):
| Подход | Решений/с | Время |
|---|---|---|
| Fresh direct scoring | 2.33 | 333.1 с |
| Serial prefix reuse | 10.75 | 72.3 с |
| Parallel suffixes | 20.03 | 38.8 с |
| Native reranker | 1.86 | 417.3 с |
Экспериментальные пути с переиспользованием.prefixes дают ускорение в ~8.6× относительно прямого подсчёта.
Качество
Браузерная лестница моделей
| Модель | Артефакт | Размер | Balanced accuracy | Agreement с Jev |
|---|---|---|---|---|
| Qwen3-0.6B | Q8_0 | 639 MB | 0.440 | 0.407 |
| MiniCPM5-2B | Q4_K_M | 1.56 GB | 0.686 | 0.637 |
| Qwen3.5-4B | Q4_K_M | 3.01 GB | 0.813 | 0.845 |
| Published Jev | Closed service | — | — | 0.883 |
Сравнение с Jev проводится по 102 строкам из публичных артефактов TypeSafe.
Общий бейзлайн
| Набор данных | Строк | Direct logits | Reranker | Jev |
|---|---|---|---|---|
| Authored decisions | 144 | 0.813 | 0.625 | — |
| WANLI | 256 | 0.637 | 0.522 | — |
| TypeSafe subset | 102 | 0.845 | 0.560 | 0.883 |
Direct logits показали себя как лучший бейзлайн для общих решений — 0.813 vs 0.625 у native reranker. Reranker силён в ранжировании retrieval, но для общих binary-решений прямое чтение логитов надёжнее.
Дополнительные метрики
На отдельных встроенных задачах:
| Задача | Direct logits | Reranker |
|---|---|---|
| Judgment grid (36 строк) | 0.806 | 0.694 |
| Action firewall (10 actions) | 0.700 | 0.700 |
| Code retrieval (6 queries) | 1.000 | 1.000 |
| Company knowledge (7 queries) | 0.929 | 0.929 |
Retrieval-задачи одинаково хорошо решаются обоими подходами, но для judgment и general decisions direct logits выигрывают с заметным отрывом.
Браузерный демо
WebGPU-демо доступно без установки: webgpu-demo/index.html. Поддерживает модели до 4B параметров в квантизации Q4_K_M. Интерактивный replay decisions доступен в demo/index.html — показывает, как typed decisions появляются вместе, пока JSON стримится токен за токеном.
Быстрый старт
Требования: Python 3.10+, CUDA, GPU с VRAM для 4B BF16 модели.
python -m venv .venv
. .venv/bin/activate
export HF_HOME=/path/to/large-drive/huggingface
pip install -e '.[test]'
Запуск:
CUDA_VISIBLE_DEVICES=0 semif-score \
  --mode direct \
  --model Qwen/Qwen3.5-4B \
  --revision 851bf6e806efd8d0a36b00ddf55e13ccb7b8cd0a \
  --input examples/decisions.jsonl \
  --output results.jsonl
Для Apple Silicon доступен MLX-бэкенд с нативным подсчётом и параллельными shared-state решениями на macOS arm64: pip install -e '.[test,mlx]' + флаг --backend mlx.
Реализуемость
Проект commercial-grade: замороженные модели, зафиксированные промпты, row-level метрики, пертурбации, точные команды воспроизведения. Всё в REPRODUCE.md.
Код под MIT-лицензией, модельные веса — по лицензиям upstream-проектов.
Источники оценок
Бейзлайны построены на нескольких независимых наборах данных:
- TypeSafe public evaluations — публичные кейсы для сравнения с Jev
- Every parallel judgment lab — данные экспериментов по параллельным суждениям
- WANLI — внешний бенчмарк natural language inference
Замороженные модели: Qwen3-0.6B, MiniCPM5-2B, Qwen3.5-4B и Qwen3-Reranker-4B. Веса моделей не включены в репозиторий, каждый скачивает их самостоятельно.
Проект был ранее известен как OpenJev и не имеет отношения к TypeSafe. Jev — закрытый коммерческий сервис; SemIf воспроизводит интерфейсный паттерн, а не модель или обучение.
Источник: https://github.com/theoleecj/semif